
На первой работе тебе не скажут «настрой Prometheus». Скажут иначе: «у нас сервис, сделай так, чтобы он выкатывался без ручного входа на сервер и чтобы мы узнавали о падении раньше клиентов». Это задача на стыке всех разделов сразу. До сих пор nginx, Docker и мониторинг жили в разных разделах, как в отдельных комнатах, а здесь их не разделить, и знание каждого по отдельности не спасает.
Итоговый проект — тренировка ровно этой задачи. Ты собираешь всё, что прошёл за двадцать разделов, в одну работающую систему: от пустых машин до приложения, которое само выкатывается по коммиту, само зовёт на помощь, когда ему плохо, и переживает потерю базы. На выходе — не сертификат, а то, что можно показать на собеседовании: работающая система с историей коммитов, схемой и разбором аварии.
Что получится в конце
Сначала картинка целиком, потом по частям. Человек открывает в браузере адрес сайта. Запрос приходит на nginx, тот снимает шифрование и передаёт его приложению в контейнере, а приложение ходит в PostgreSQL. Это та же цепочка, что ты строил в разделах про nginx, Docker и базы, — только теперь она собрана на отдельной машине и описана кодом.
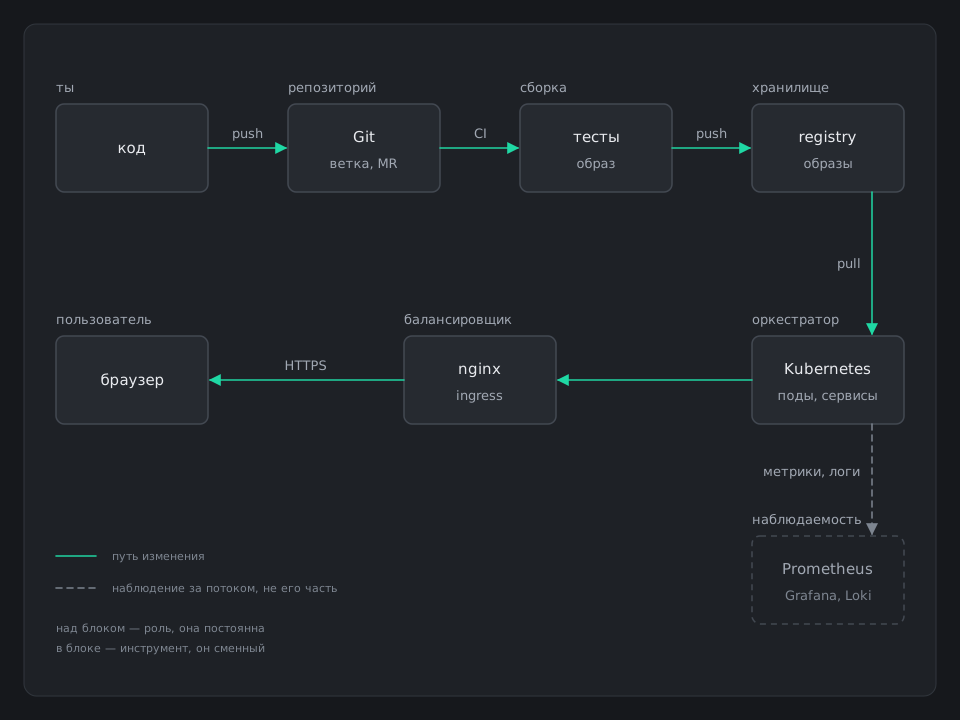
Рядом с потоком запросов идёт поток изменений. Коммит — твоя правка конфига или новая версия кода от разработчика — уезжает в собственный GitLab, конвейер собирает образ, проверяет его и выкатывает на сервер. Руками на сервер никто не заходит — это и есть главное отличие проекта от набора учебных стендов.
Чтобы это всё жило не на честном слове, нужно ещё две вещи — наблюдение и запасной план, о них дальше.
Две машины и почему не одна
Всё можно было бы поставить на одну машину, но тогда у системы появляется слабое место, которое хорошо видно на бытовом примере. Пожарная сигнализация, у которой датчик и сирена висят в той же комнате, где начался пожар, сгорит вместе с комнатой. Мониторинг, живущий на том же диске, что и приложение, ляжет вместе с ним — и никто не узнает.
Поэтому машин две:
| Машина | Что на ней | Память |
|---|---|---|
| final-app | nginx, приложение, PostgreSQL, реестр образов, раннер конвейера, сборщик метрик и журналов | 4 ГБ |
| final-ops | GitLab, Prometheus, Alertmanager, Grafana, Loki, копии бэкапов | 8 ГБ |
Читать таблицу стоит по второй колонке. На final-app — только то, что обслуживает пользователя, плюс маленькие агенты, которые отправляют метрики и журналы наружу. Всё, что наблюдает, хранит историю и копии, живёт на final-ops. Упадёт одна — вторая расскажет, что случилось.
Про память. GitLab — самый прожорливый жилец курса: как и в разделе 12, считай, что работающий GitLab держит около 6 ГБ даже с урезанными настройками. Рядом с ним на final-ops живут Prometheus, Grafana и Loki, им нужно ещё 1–2 ГБ, отсюда 8. На final-app раннер собирает образы, а сборка Python-образа рядом с базой и реестром легко съедает 2 ГБ — отсюда 4. Если поставить меньше, машина начнёт убивать процессы по нехватке памяти, и Loki или Prometheus будут молча перезапускаться.
Если 8 ГБ на одну машину не по карману, есть честный запасной путь: GitLab на gitlab.com, раннер всё так же на final-app. Тогда final-ops хватит 4 ГБ, а шаги про установку GitLab в практике конвейера ты пропускаешь. Запиши этот выбор в журнал решений.
Рабочая машина — стенд курса, с которого ты запускаешь Terraform и Ansible, — остаётся как была: она только управляет и памяти проекта не требует.
Сколько это стоит
Проект займёт два-три выходных, и всё это время машины в облаке тикают. Посчитать точную сумму для своих размеров проще всего калькулятором облака, как в разделе 14: 2 ядра и 4 ГБ плюс 2 ядра и 8 ГБ, два диска по 20–30 ГБ и два статических публичных адреса. Грант новичка из раздела 14 к этому моменту, скорее всего, кончился — проверь баланс до старта.
Главная экономия — останавливать машины между вечерами работы. Остановленная машина не платит за процессор и память, только за диск и зарезервированный публичный адрес. Адрес резервируем специально: иначе после каждого включения он менялся бы, и пришлось бы править ~/.ssh/config и /etc/hosts. Прерываемые машины, которые облако само гасит раз в сутки, для проекта не годятся: на них ночной бэкап и учебная авария ловят выключенную машину.
Если машин у тебя две виртуалки на ноутбуке или домашнем сервере, а не облако, — это нормально и бесплатно. Важно не где они стоят, а то, что они описаны кодом.
Почему без Kubernetes
Три раздела курса ушли на Kubernetes, а в основном проекте его нет, — и это осознанно. Один сервис на одной машине Compose описывает проще и прозрачнее: меньше движущихся частей, а значит, понятнее, что сломалось. Кластер оправдан, когда сервисов и машин много.
Но показать Kubernetes работодателю всё равно нужно, особенно если целишься в платформенную команду. Поэтому у проекта есть девятый этап: то же приложение переезжает в k3s со своим Helm-чартом, входом по HTTPS и Argo CD, который забирает выкаты из твоего GitLab. Он идёт после основного проекта и по желанию — сначала система должна заработать целиком.
Девять признаков готовности
Проект без критериев готовности не заканчивается никогда: всегда есть что подкрутить. Поэтому заранее договоримся, по каким признакам он сделан. Каждый признак проверяется командой или действием, а не ощущением «вроде работает».
Обрати внимание на восьмой пункт, про бэкап: «скрипт отработал» здесь не считается. Это то же правило, что в разделе про базы данных, — копия, из которой ни разу не восстанавливались, ничего не гарантирует.
Девять признаков сразу — это много, и браться за все одновременно — верный способ не довести до конца ни один.
Почему не всё сразу
Соблазн понятен: открыть пустой .gitlab-ci.yml и написать конвейер, который сразу всё создаст, настроит и выкатит. Так делают почти все в первый раз, и почти все застревают: когда падает такой конвейер, непонятно, что сломалось — код, сервер, сеть или сам конвейер.
Правило проекта простое: сначала руками, потом автоматизация этого пути. Приложение один раз поднимается командами, ты видишь, что оно отвечает, — и только потом те же шаги переезжают в конвейер. Это то же движение, что в разделах курса: Docker руками, затем Compose, затем CI/CD.
И второе правило: каждый этап заканчивается коммитом и проверкой. Сломал что-то на пятом этапе — откатываешься к концу четвёртого, а не начинаешь заново.
Как разложить работу по этапам и сколько времени на каждый — следующий урок.
Словарь урока
Что спросят на собеседовании
- Расскажите про свой пет-проект.Не перечень технологий, а задача и решение: что за сервис, как он выкатывается, как вы узнаёте о падении, что сломалось и как чинили. Подробно — в уроке раздела про портфолио.
- Почему мониторинг не стоит ставить на ту же машину, что и сервис?Общая точка отказа: кончится диск или память — встанут оба, и оповещение никто не отправит. Наблюдатель должен пережить того, за кем наблюдает.
- Как вы поймёте, что инфраструктура описана кодом полностью?Пустой план Terraform и ноль изменений на повторном прогоне Ansible. Если план что-то предлагает — кто-то правил руками или описание неполное.
Что дальше
Цель и признаки понятны. Дальше — план: восемь этапов и девятый по желанию, в каком порядке их делать, сколько уходит на каждый и как разложить репозиторий, чтобы через месяц в нём можно было разобраться.