
В 2012 году инженеры музыкального сервиса SoundCloud, вдохновившись внутренней системой Google, написали Prometheus — программу, которая раз в несколько секунд опрашивает сервисы, записывает отданные ими числа с отметкой времени и позволяет потом задавать по этим числам вопросы. В 2016-м он стал вторым проектом фонда CNCF после Kubernetes. Сегодня это стандарт: в вакансиях DevOps-инженера его упоминают почти всегда, а в Kubernetes он стоит в каждом втором кластере.
Из урока ты узнаешь, откуда Prometheus берёт числа, как они выглядят и какую ошибку с ними делают чаще всего. Сразу о границах: он не хранит логи, не рисует красивых дашбордов (для этого Grafana) и не рассылает сообщения (для этого Alertmanager). В ноябре 2024 года вышла версия 3.0 — если статья старше, синтаксис в ней почти тот же, но интерфейс уже другой.
Он сам ходит за данными
Большинство старых систем мониторинга ждали, что программы пришлют им данные сами. Prometheus устроен наоборот: он сам приходит к каждой программе по адресу /metrics и забирает то, что там лежит. Такую модель называют pull — «забираю сам».
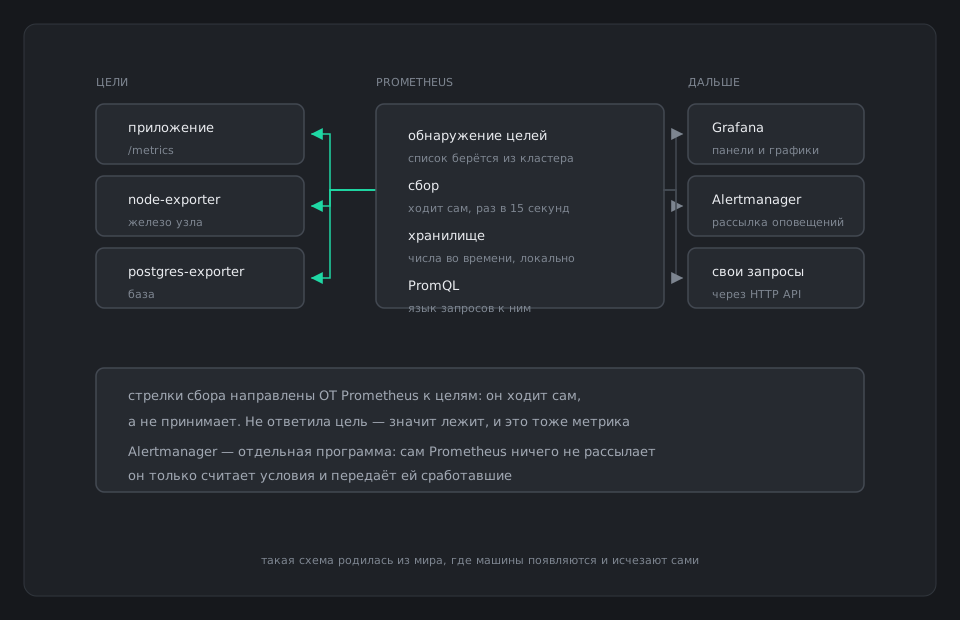
Каждый адрес, который Prometheus опрашивает, называется целью (target). Список целей ты пишешь в его настройках, интервал опроса по умолчанию — 15 секунд. На каждый опрос он заводит служебную метрику up: 1, если цель ответила, и 0, если нет. Это первое, что смотрят при любой настройке, и первое правило оповещения, которое мы напишем.
Остаётся вопрос: а кто выставит страницу /metrics у Linux или у PostgreSQL, которые про Prometheus ничего не знают?
Экспортёры
Для этого есть экспортёры — маленькие программы-переводчики. Экспортёр читает данные из системы на её родном языке и выставляет их страницей /metrics в формате Prometheus.
Приложение компании может отдавать метрики и без экспортёра: разработчики подключают библиотеку, и у приложения появляется свой адрес /metrics. Писать этот код — работа разработчика, а твоя — добавить адрес в цели и проверить, что метрики собираются.
Экспортёр отдаёт обычную страницу текста, и умение её прочитать экономит время: по ней сразу видно, отдаёт ли цель то, чего ты ждёшь.
Как выглядит метрика
Страница /metrics — обычный текст, его можно прочитать командой curl. Флаг -s (silent, тихо) убирает полоску загрузки, а grep оставляет нужные строки.
curl -s localhost:9100/metrics | grep node_load
node_load1 0.42
node_load15 0.31
node_load5 0.37
Каждая строка — имя метрики и её текущее значение. Здесь это средняя нагрузка машины за 1, 5 и 15 минут — те самые три числа, что ты видел в выводе uptime в разделе про Linux.
У многих метрик есть метки — уточнения в фигурных скобках:
node_filesystem_avail_bytes{mountpoint="/"} 2.1e+10
node_filesystem_avail_bytes{mountpoint="/boot"} 8.9e+08
Одна метрика «свободные байты», две метки — два разных набора чисел, для корня и для /boot. Каждое сочетание имени и меток Prometheus хранит отдельно и называет временным рядом. Запись 2.1e+10 — это 2,1 умножить на десять в десятой, то есть около 21 гигабайта.
По поведению метрики делятся на типы, и от типа зависит, как их потом спрашивать.
Три типа, которые встретятся
Тип подсказывает, что с метрикой можно делать. На первое время хватит трёх.
| Тип | Как ведёт себя | Пример |
|---|---|---|
| counter, счётчик | только растёт, сбрасывается при перезапуске | число запросов с момента запуска |
| gauge, датчик | ходит вверх и вниз | свободная память, температура |
| histogram, гистограмма | раскладывает значения по корзинам | время ответа: сколько уложилось в 0,1 с, в 0,5 с |
Возьмём первую строку. Число запросов с запуска само по себе бесполезно: «сорок тысяч» — это много или мало? Интересна скорость его роста, запросов в секунду, и её считают функцией, которую разберём в следующем уроке. Имена счётчиков по договорённости кончаются на _total, по этому хвосту их и узнают.
Есть и четвёртый тип, summary, но в новых программах его почти не используют — достаточно знать, что такой бывает.
Метки: главная ошибка
Метки удобны, и именно поэтому на них совершают самую дорогую ошибку. Каждое новое значение метки — новый временной ряд, а ряды Prometheus держит в памяти.
Метка method с пятью значениями (GET, POST и так далее) — пять рядов, это нормально. Метка user_id с идентификатором пользователя — миллион рядов на одну метрику. Хранилище съедает всю память и падает, причём через неделю после выката, когда пользователей накопилось достаточно. Число рядов называют кардинальностью, а ошибку — «взрывом кардинальности».
Правило запоминается одной фразой: в метку кладут только то, у чего мало возможных значений. Идентификаторы, адреса, полные пути с параметрами — в логи, не в метки.
Словарь урока
Что спросят на собеседовании
- Pull или push — как работает Prometheus и почему это удобно?Pull: сам опрашивает цели. Если цель не ответила, он знает об этом сразу (up = 0), и список целей живёт в одном месте.
- Что такое экспортёр? Приведи примеры.Программа, которая переводит метрики системы в формат Prometheus: node-exporter для машины, cAdvisor для контейнеров, postgres-exporter для базы.
- Чем counter отличается от gauge?Counter только растёт, его смотрят через скорость роста. Gauge показывает текущее значение и может уменьшаться.
Что дальше
Хватит теории — в практике поднимем Prometheus с двумя экспортёрами на Compose и увидим свои первые цели.