
Первые четыре этапа описывали движение: код едет от репозитория к пользователю. Но движение возможно только потому, что под ним есть опора — серверы, на которых всё запускается, наблюдаемость, по которой видно результат, и данные, которые всё это обслуживает.
Это те самые части, которые в презентациях рисуют мелким шрифтом внизу схемы. В работе они занимают половину времени.
Инфраструктура, описанная кодом
Серверы, сети, диски, правила доступа можно создать руками в веб-панели — и первое время так и делают. Ломается это на вопросе «а как оно устроено»: через полгода никто не помнит, какие галочки были поставлены и почему.
Поэтому инфраструктуру описывают файлами, которые лежат в репозитории: запустил такой файл — и получил те же серверы и настройки, сколько бы раз ни запускал. Сами машины чаще всего арендуют в облаке — у провайдера, который за минуту выдаёт сервер, сеть и диск по запросу. Инструментов для описания два, и они отвечают на разные вопросы.
| Инструмент | Что делает | Пример задачи |
|---|---|---|
Terraform | Создаёт ресурсы: серверы, сети, диски | Поднять три виртуалки и сеть между ними |
Ansible | Приводит существующий сервер в нужное состояние | Установить nginx и разложить конфиг |
Разница простая: Terraform отвечает на вопрос «что должно существовать», Ansible — «как оно должно быть настроено внутри». На практике их связывают в цепочку: первый поднял сервер, второй его настроил.
Разделы курса: 13 Ansible, 14 Облако, 15 Terraform.
Инфраструктура описана — на ней уже можно что-то запускать. Остаётся понять, работает ли оно.
Видно, что происходит
Выкат прошёл — и тут возникает вопрос, на который без подготовки ответить нечем: стало лучше или хуже? Чтобы отвечать на него не догадками, собирают три вида сигналов. В вакансиях их называют «тремя столпами наблюдаемости».
Сами по себе сигналы ничего не делают: на график смотрят, когда уже знают, что что-то не так. Поэтому поверх метрик пишут оповещения — правила вида «ошибок больше 5% пять минут подряд — напиши дежурному». Узнать о поломке первым, раньше пользователей, — работа оповещения.
Что ломается: оповещения приходят так часто, что их перестают читать; метрики есть, а правил нет; логи лежат на сервере, который как раз и упал.
Разделы курса: 10 Мониторинг, 11 Логирование.
Данные
Данные вынесены отдельно по одной причине: это единственное, что нельзя пересоздать. Приложение переживёт потерю контейнера — поднимется из того же образа. База не переживёт ничего: её содержимое существует в одном экземпляре.
Отсюда другие требования и другие привычки: копии, регулярная проверка восстановления, отдельный подход к изменению схемы.
Что ломается: копия, которую никто не пробовал восстанавливать; миграция схемы, выполненная одновременно с выкатом и уронившая обе версии приложения; база, доступная из интернета.
Раздел курса: 09 Базы данных — PostgreSQL и Redis.
Почему разделы идут именно в таком порядке
Теперь видно всю картину — и заодно понятно, почему курс устроен так, а не иначе. Разделов двадцать один, но шагов на самом деле шесть, и каждый следующий имеет смысл только поверх предыдущего.
Сначала ты собираешь стек руками: система, сеть, веб-сервер, история изменений, контейнеры и база. Потом учишься видеть, что с ним происходит, — метрики и логи. Только после этого его доставку автоматизируют конвейером на собственном GitLab, затем описывают кодом инфраструктуру, на которой он живёт, и передают его оркестратору. В конце — отладка настоящих поломок и итоговый проект, где всё собирается вместе.
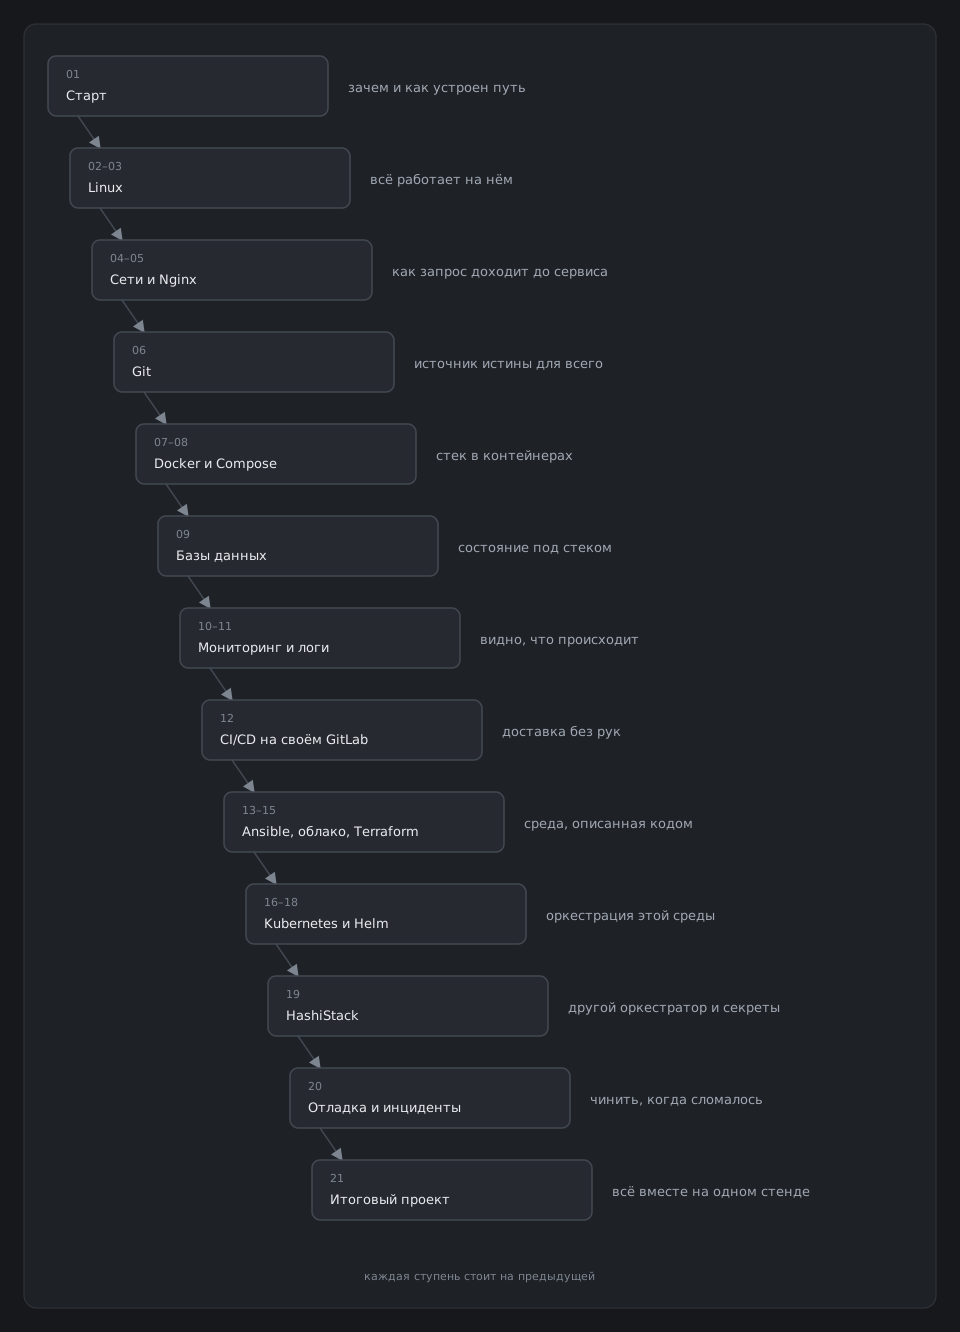
Попытка начать с Kubernetes, минуя Linux и сети, заканчивается одинаково: команды из статьи выполняются, а при первой ошибке становится непонятно, где смотреть. Под ним в курсе пятнадцать разделов — и ни один не лишний.
Три вопроса, которые делают карту полезной
Путь изменения часто рисуют красивой схемой в презентации и на этом останавливаются. Практическая ценность появляется, когда по каждому этапу можешь ответить на три вопроса:
- Чем он автоматизирован?
- Где смотреть, если он сломался?
- Как откатить?
Если хотя бы на один ответа нет — это и есть твоя следующая задача, а не «внедрить ещё один инструмент». Возвращайся к этим вопросам после каждого раздела курса: список этапов без ответов будет сокращаться, и это самый честный показатель прогресса.
Словарь урока
Что спросят на собеседовании
- Чем Terraform отличается от Ansible?Terraform создаёт ресурсы и отвечает за то, что существует; Ansible настраивает уже существующие машины. Их связывают: Terraform поднял сервер, Ansible его настроил.
- Что такое наблюдаемость?Возможность по внешним сигналам понять, что происходит внутри системы. Складывается из метрик, логов и трассировок. Поверх них пишут оповещения, иначе это просто графики, на которые никто не смотрит.
- Почему данные требуют отдельного подхода?Их нельзя пересоздать из образа. Отсюда копии, проверка восстановления и осторожность с изменением схемы.
- С чего начать разбор незнакомой инфраструктуры?Пройти путь изменения по этапам и на каждом спросить: чем автоматизирован, где смотреть при поломке, как откатить. Пробелы и будут списком задач.
Что дальше
Карта разобрана целиком. Следующий урок — отступление, но важное: как на эту карту влияет ИИ. Что модели уже взяли на себя, где они ошибаются и что от этого меняется в работе инженера.